Cache KV
Por que gerar texto token a token é retrabalho e como o cache KV é a solução.
 Wenderson Melo3 min de leitura
No fim do texto sobre Transformers, deixei um problema em aberto. O decoder gera a resposta um token por vez, e cada token escolhido volta como entrada para o próximo. Se o modelo fizer tudo de novo a cada passo, ele recalcula as keys e os values de todos os tokens anteriores, mesmo que eles não mudem.
O cache KV evita esse retrabalho. O modelo guarda as keys (K) e os values (V) de cada token assim que os calcula, e nos passos seguintes faz as contas só do token novo. Ele é uma das melhorias aplicadas sobre a estrutura do artigo para reduzir o custo de rodar o modelo. Neste texto, vamos ver como ele funciona.
O retrabalho na geração
No Transformer do artigo, o decoder gera a saída um token por vez. A cada passo, ele recebe todos os tokens já gerados e prevê o próximo. Sem cache, cada passo roda o decoder sobre essa sequência inteira, e quase todo esse trabalho já foi feito no passo anterior. Num modelo que atende muita gente ao mesmo tempo, esse retrabalho vira tempo de GPU e, no fim, custo.
Para ver onde está o retrabalho, retomo a autoatenção do texto anterior. Cada token gera uma query, uma key e um value a partir do seu vetor. Juntas, elas formam as matrizes Q, K e V, com uma linha por token, e a atenção de todos os tokens sai de uma conta só:1
Atenção(Q, K, V) = softmax(Q · Kᵀ / √dₖ) · VNo decoder, uma máscara põe −∞ nos escores das posições futuras antes do softmax, e elas ficam com peso zero.1 A animação mostra essa conta para “O gato subiu”, com vetores de dimensão 2, e depois a entrada do token “no”.

Quando “no” entra, as linhas antigas não mudam, porque para elas “no” é uma posição futura. A única linha nova é a de “no”, que precisa da query dele e das keys e dos values dos quatro tokens. Sem cache, o modelo refaz a tabela inteira a cada passo para usar só a última linha. E isso vale para todas as camadas: se as saídas dos tokens antigos não mudam numa camada, os vetores que eles levam para a camada seguinte também não mudam, e nem as keys e os values que eles geram lá.
Como funciona o cache KV
Para prever o próximo token, o modelo só precisa da linha nova da tabela de atenção. Essa linha usa a query do token novo e as keys e os values de todos os tokens. A query sai do próprio token novo. As keys e os values dos anteriores já foram calculados nos passos de antes e, como vimos, não mudam, basta salvá-los.
É isso que o cache faz. A cada passo, em cada camada e em cada cabeça de atenção, o modelo calcula a query, a key e o value só do token novo, lê as keys e os values antigos do cache e acrescenta os novos a ele. A animação compara os dois jeitos de gerar “gato subiu no telhado” a partir de “O”.

O que o cache resolve
No fim, o cache KV resolve o retrabalho da geração. Sem ele, cada token novo fazia o modelo passar de novo por todos os tokens anteriores. Com ele, só o token novo passa pelo modelo, e os anteriores entram na conta pelas keys e pelos values guardados.
Porém, ele também tem os seus limites. O trabalho de cada passo ainda cresce com o tamanho do texto, porque a query nova é comparada com as keys de todos os tokens anteriores. E ele vale só para uma geração: quando a resposta termina, ele é descartado, e a próxima requisição começa do zero, mesmo que comece com o mesmo trecho do prompt anterior. Reaproveitar o cache entre requisições é a ideia do prompt caching, que provavelmente será abordado em algum texto aqui.
Resumindo: sem cache, cada token novo faz o modelo recalcular as keys e os values de todos os anteriores, embora eles não mudem. O cache KV guarda esses valores na primeira vez, e cada passo calcula só o token novo. Ele não elimina todo o custo, porque a atenção ainda olha para todos os tokens, e vale só durante uma geração.
Obrigado! :)
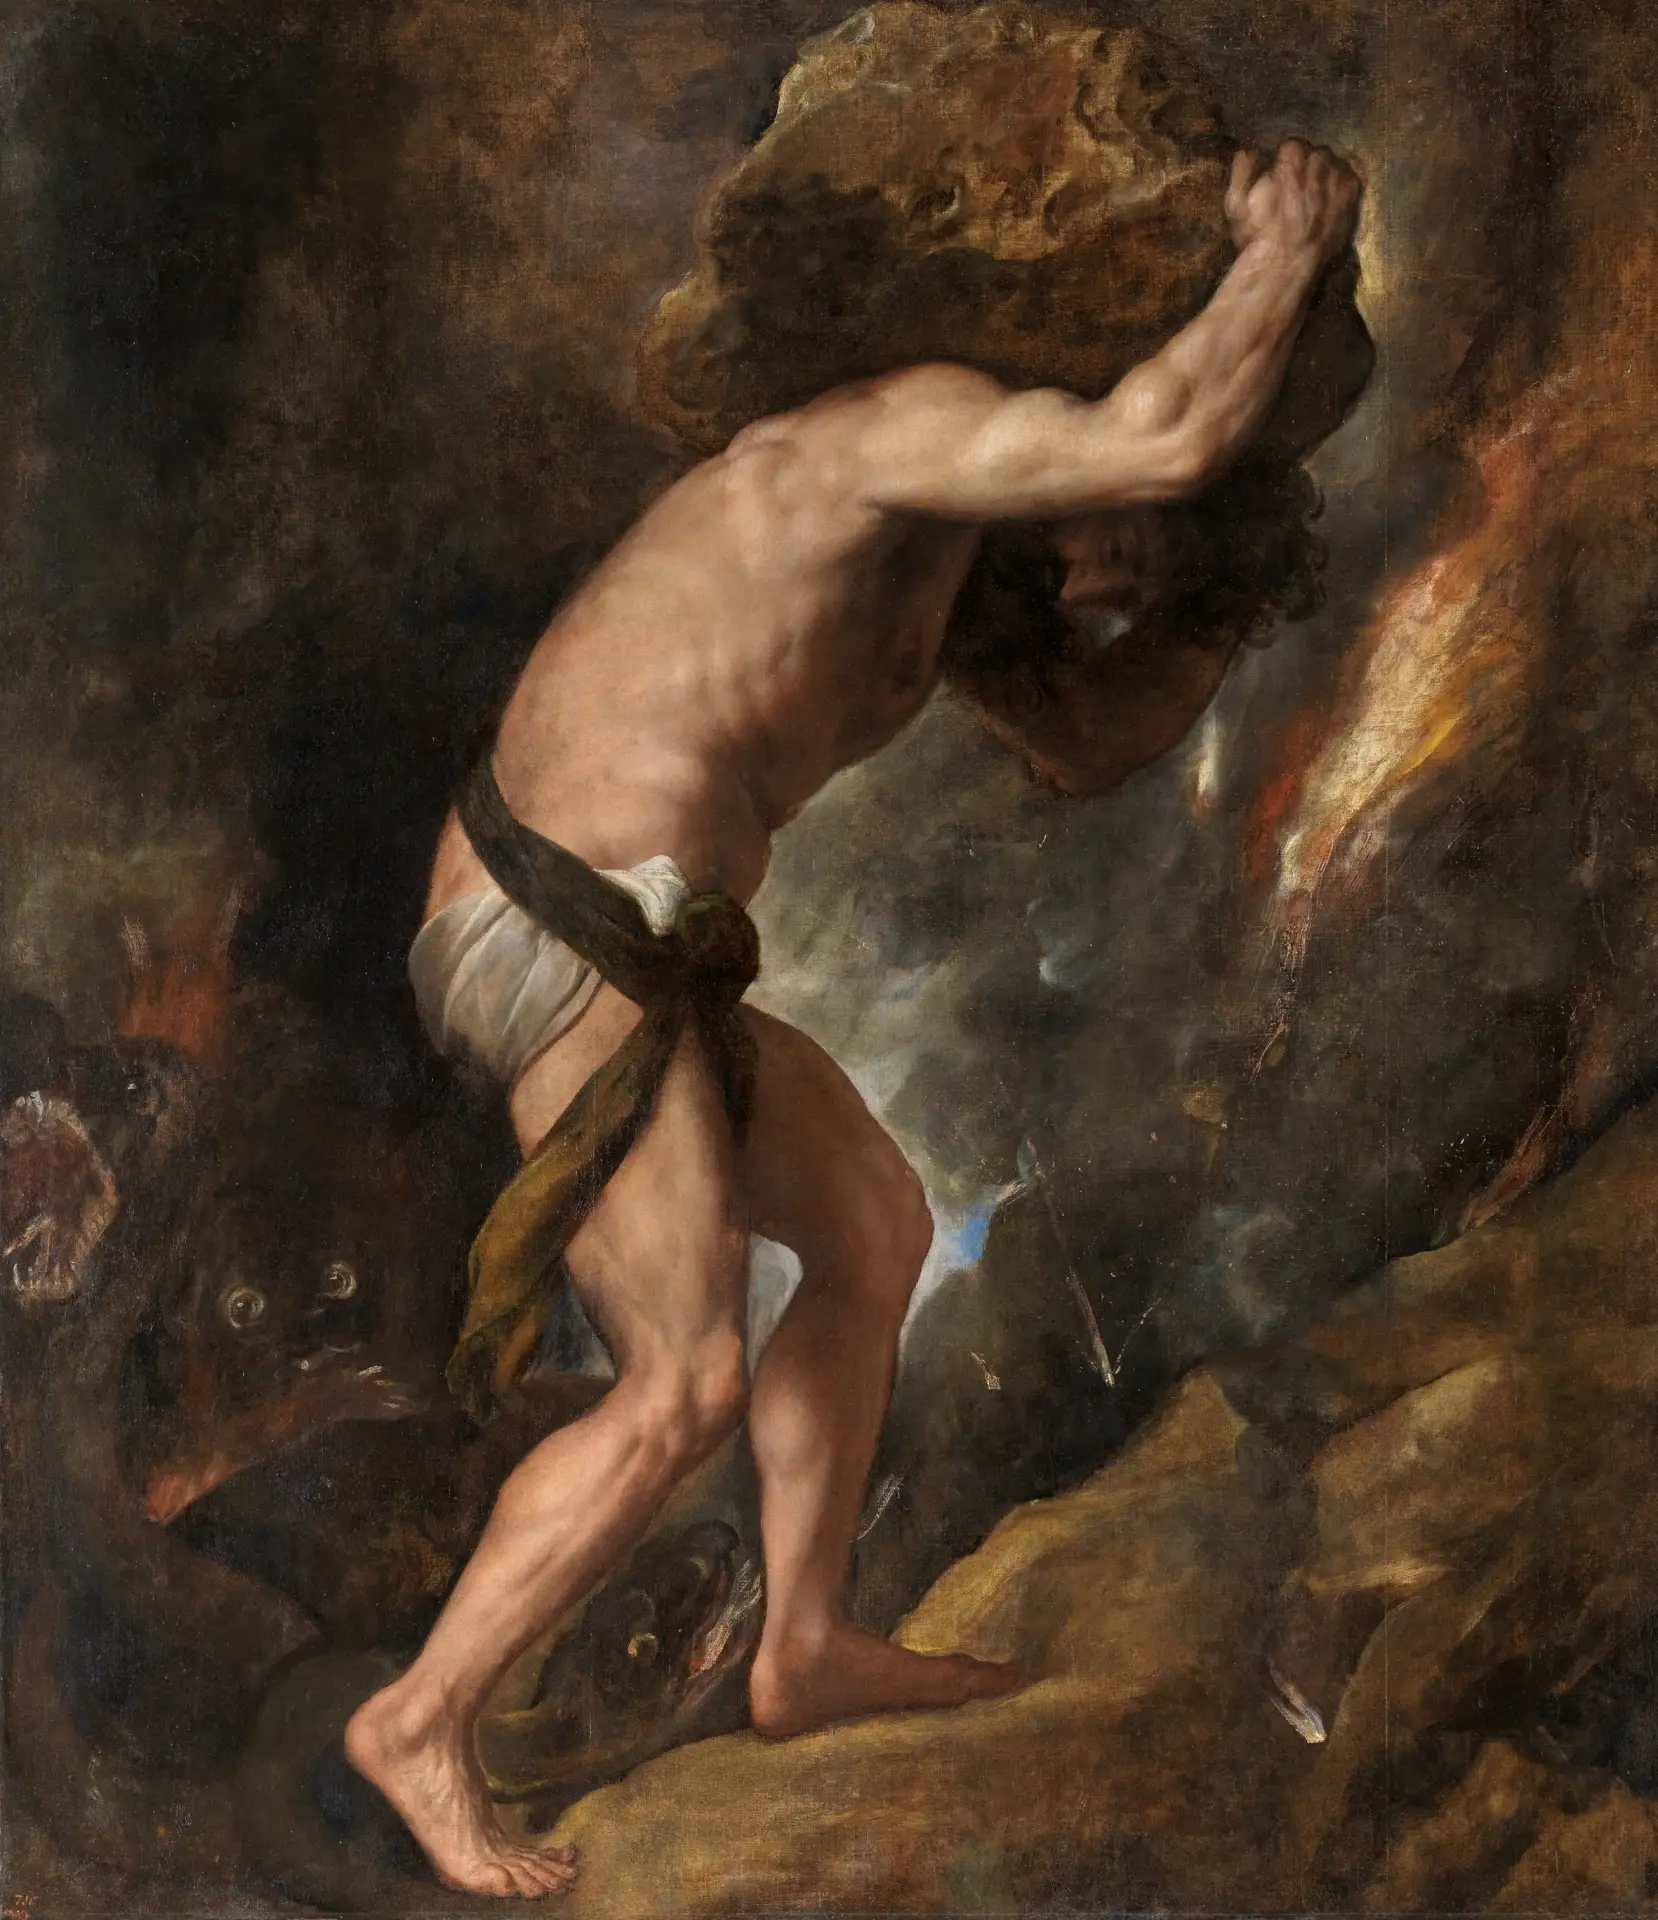
A pintura do topo é “Sísifo”, de Ticiano (1548–1549). No mito, Sísifo foi condenado a empurrar uma pedra morro acima, e ela sempre rolava de volta antes do topo. É uma boa representação da geração sem cache, em que cada token novo refaz o trabalho que já tinha sido feito.
Notas
-
Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A. N.; Kaiser, Ł.; Polosukhin, I. Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NeurIPS 2017). arXiv:1706.03762. https://arxiv.org/abs/1706.03762 ↩ ↩2